笔试笔记
最后更新时间:
文章总字数:
预计阅读时间:
摘要
本文为自用某笔试大纲及对应知识点。
知识点内容根据各个教程收集整理。
所有教程版权归各自作者所有。
C语言程序设计
C语言概述
C语言是一种计算机程序设计语言。它既有高级语言的特点,又具有汇编语言的特点。它可以作为系统设计语言,编写工作系统应用程序,也可以作为应用程序设计语言,编写不依赖计算机硬件的应用程序.
原链接
特点:
- 易于学习。
- 结构化语言。
- 它产生高效率的程序。
- 它可以处理底层的活动。
- 它可以在多种计算机平台上编译。
原链接
数据类型
此部分原链接
基本类型
基本类型可分为整数类型和浮点类型
整数类型
| 类型 | 取值范围 |
|---|---|
| char | -128 到 127 或 0 到 255 |
| unsigned char | 0 到 255 |
| signed char | -128 到 127 |
| int | -32,768 到 32,767 或 -2,147,483,648 到 2,147,483,647 |
| unsigned int | 0 到 65,535 或 0 到 4,294,967,295 |
| short | -32,768 到 32,767 |
| unsigned short | 0 到 65,535 |
| long | -2,147,483,648 到 2,147,483,647 |
| unsigned long | 0 到 4,294,967,295 |
注:各种类型的存储大小与系统位数有关
浮点类型
| 类型 | 范围 | 精度 |
|---|---|---|
| float | 1.2E-38 到 3.4E+38 | 6 位有效位 |
| double | 2.3E-308 到 1.7E+308 | 15 位有效位 |
| long double | .4E-4932 到 1.1E+4932 | 19 位有效位 |
获取储存大小
使用sizeof(),表达式 sizeof(type) 得到对象或类型的存储字节大小.
如:
1 | |
void 类型
void 类型指定没有可用的值。通常用于以下三种情况下:
- 函数返回为空。C 中有各种函数都不返回值,或者您可以说它们返回空。不返回值的函数的返回类型为空。例如 void exit (int status);
- 函数参数为空。 C 中有各种函数不接受任何参数。不带参数的函数可以接受一个 void。例如 int rand(void);
- 指针指向 void。 类型为 void * 的指针代表对象的地址,而不是类型。例如,内存分配函数 void *malloc( size_t size ); 返回指向 void 的指针,可以转换为任何数据类型。
运算符与表达式
运算符
此部分原链接
算术运算符
| 运算符 | 描述 |
|---|---|
| + | 把两个操作数相加 |
| - | 从第一个操作数中减去第二个操作数 |
| * | 把两个操作数相乘 |
| / | 分子除以分母 |
| % | 取模运算符,整除后的余数 |
| ++ | 自增运算符,整数值增加 1 |
| -- | 自减运算符,整数值减少 1 |
| 运算符 | 描述 |
|---|---|
| a++ | 先赋值后运算 |
| ++a | 先运算后赋值 |
关系运算符
| 运算符 | 描述 |
|---|---|
| == | 检查两个操作数的值是否相等,如果相等则条件为真。 |
| != | 检查两个操作数的值是否相等,如果不相等则条件为真。 |
| > | 检查左操作数的值是否大于右操作数的值,如果是则条件为真。 |
| < | 检查左操作数的值是否小于右操作数的值,如果是则条件为真。 |
| >= | 检查左操作数的值是否大于或等于右操作数的值,如果是则条件为真。 |
| <= | 检查左操作数的值是否小于或等于右操作数的值,如果是则条件为真。 |
逻辑运算符
| 运算符 | 描述 |
|---|---|
| && | 逻辑与运算符。如果两个操作数都非零,则条件为真。 |
| || | 逻辑或运算符。如果两个操作数中有任意一个非零,则条件为真。 |
| ! | 逻辑非运算符。用来逆转操作数的逻辑状态。如果条件为真则逻辑非运算符将使其为假。 |
位运算符
位运算符作用于位,并逐位执行操作。
&、 | 和 ^ 的真值表如下所示:
| p | q | p & q | p | q | p ^ q |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 1 | 0 | 1 | 1 |
| 1 | 1 | 1 | 1 | 0 |
| 1 | 0 | 0 | 1 | 1 |
假设如果 A = 60,且 B = 13,现在以二进制格式表示,它们如下所示:
A = 0011 1100
B = 0000 1101
A&B = 0000 1100
A|B = 0011 1101
A^B = 0011 0001
~A = 1100 0011
下表显示了 C 语言支持的位运算符。假设变量 A 的值为 60,变量 B 的值为 13,则:
| 运算符 | 描述 | 实例 |
|---|---|---|
| & | 按位与操作,按二进制位进行”与”运算。运算规则: 0&0=0; 0&1=0; 1&0=0; 1&1=1; | (A & B) 将得到 12,即为 0000 1100 |
| | | 按位或运算符,按二进制位进行”或”运算。运算规则: 0 | 0=0; 0 |
| ^ | 异或运算符,按二进制位进行”异或”运算。运算规则: 0^0=0; 0^1=1; 1^0=1; 1^1=0; | (A ^ B) 将得到 49,即为 0011 0001 |
| ~ | 取反运算符,按二进制位进行”取反”运算。运算规则: ~1=-2; ~0=-1; | (~A ) 将得到 -61,即为 1100 0011,一个有符号二进制数的补码形式。 |
| << | 二进制左移运算符。将一个运算对象的各二进制位全部左移若干位(左边的二进制位丢弃,右边补0). | A << 2 将得到 240,即为 1111 0000 |
| >> | 二进制右移运算符。将一个数的各二进制位全部右移若干位,正数左补0,负数左补1,右边丢弃。 | A >> 2 将得到 15,即为 0000 1111 |
赋值运算符
| 运算符 | 描述 | 实例 |
|---|---|---|
| = | 简单的赋值运算符,把右边操作数的值赋给左边操作数 | C = A + B 将把 A + B 的值赋给 C |
| += | 加且赋值运算符,把右边操作数加上左边操作数的结果赋值给左边操作数 | C += A 相当于 C = C + A |
| -= | 减且赋值运算符,把左边操作数减去右边操作数的结果赋值给左边操作数 | C -= A 相当于 C = C - A |
| *= | 乘且赋值运算符,把右边操作数乘以左边操作数的结果赋值给左边操作数 | C *= A 相当于 C = C * A |
| /= | 除且赋值运算符,把左边操作数除以右边操作数的结果赋值给左边操作数 | C /= A 相当于 C = C / A |
| %= | 求模且赋值运算符,求两个操作数的模赋值给左边操作数 | C %= A 相当于 C = C % A |
| <<= | 左移且赋值运算符 | C <<= 2 等同于 C = C << 2 |
| >>= | 右移且赋值运算符 | C >>= 2 等同于 C = C >> 2 |
| &= | 按位与且赋值运算符 | C &= 2 等同于 C = C & 2 |
| ^= | 按位异或且赋值运算符 | C ^= 2 等同于 C = C ^ 2 |
| |= | 按位或且赋值运算符 | C |= 2 等同于 C = C | 2 |
杂项运算符
| 运算符 | 描述 | 实例 |
|---|---|---|
| sizeof() | 返回变量的大小。 | sizeof(a) 将返回 4,其中 a 是整数。 |
| & | 返回变量的地址. | &a; 将给出变量的实际地址。 |
| * | 指向一个变量。 | *a; 将指向一个变量。 |
| ? : | 条件表达式 | 如果条件为真 ? 则值为 X : 否则值为 Y |
表达式
此部分原链接
什么是表达式?
表达式是由一系列运算符(operators)和操作数(operands)组成的序列。这既是表达式的定义,同时也指明了表达式的组成成分。运算符指明了要进行何种运算和操作,而操作数则是运算符操作的对象。
表达式有什么作用(表达式的目的)?
继续解读标准,可以看到表达式的目的有如下几个:
- 计算数值(computation of a value)。
表达式“3+2”的目的就是计算数值3和2的和。与此同时,表达式同时也表示这个计算所得到的值。具体的可以参阅下面的“表达式的属性有哪些”小节。 - 指明数据对象或者函数(designates an object or a function)
例如程序中有int i;声明语句,那么表达式i=3中子表达式i就指代i所代表的那个对象(object),即一块连续的内存空间。
而在表达式&printf中printf指代的是标准C库中的printf函数。 - 产生副作用(generate side effects)
副作用(side effects)就是运行时对数据对象或文件的修改。- 表达式 i = 50的副作用是将变量i的值设置为50,这样说是不是让你感到惊讶呢? 这怎么可能是副作用呢,看起来更像是主要目的啊! 然而,从C的角度来看,主要的目的却是对表达式求值。
- 表达式printf(“ABC”)的值为3(实际打印的字符数,不包括字符’\0’),副作用就是在标准输出设备上连续打印字符A、B和C。
- 注:并不是所有的表达式都有副作用,表达式2+3的值为5,但是没有任何副作用。
- 以上目的的组合(combination)
表达式的属性有哪些(表达式的属性)?
任何表达式都有值和类型两个基本属性。
循环控制
循环语句允许我们多次执行一个语句或语句组
此部分原链接
循环类型
C 语言提供了以下几种循环类型:
| 循环类型 | 描述 |
|---|---|
| while 循环 | 当给定条件为真时,重复语句或语句组。它会在执行循环主体之前测试条件。 |
| for 循环 | 多次执行一个语句序列,简化管理循环变量的代码。 |
| do…while 循环 | 除了它是在循环主体结尾测试条件外,其他与 while 语句类似。 |
| 嵌套循环 | 您可以在 while、for 或 do..while 循环内使用一个或多个循环。 |
循环控制语句
循环控制语句改变你代码的执行顺序,通过它们可以实现代码的跳转。
C 提供了下列的循环控制语句:
| 控制语句 | 描述 |
|---|---|
| break 语句 | 终止循环或 switch 语句,程序流将继续执行紧接着循环或 switch 的下一条语句。 |
| continue 语句 | 告诉一个循环体立刻停止本次循环迭代,重新开始下次循环迭代。 |
| goto 语句 | 将控制转移到被标记的语句。但是不建议在程序中使用 goto 语句。 |
数组
C 语言支持数组数据结构,它可以存储一个固定大小的相同类型元素的顺序集合。数组是用来存储一系列数据,但它往往被认为是一系列相同类型的变量。
声明数组
在 C 中要声明一个数组,需要指定元素的类型和元素的数量:type arrayName [ arraySize ];.这叫做一维数组。arraySize 必须是一个大于零的整数常量,type 可以是任意有效的 C 数据类型。
访问数组元素
数组元素可以通过数组名称加索引进行访问。元素的索引是放在方括号内,跟在数组名称的后边。例如:double salary = balance[9];
多维数组
C 语言支持多维数组。多维数组声明的一般形式如下:
1 | |
二维数组
多维数组最简单的形式是二维数组。一个二维数组,在本质上,是一个一维数组的列表。声明一个 x 行 y 列的二维整型数组,形式如下:
1 | |
其中,type 可以是任意有效的 C 数据类型,arrayName 是一个有效的 C 标识符。一个二维数组可以被认为是一个带有 x 行和 y 列的表格。下面是一个二维数组,包含 3 行和 4 列:
1 | |
数组作为参数
如果您想要在函数中传递一个一维数组作为参数,您必须以下面三种方式来声明函数形式参数,这三种声明方式的结果是一样的,因为每种方式都会告诉编译器将要接收一个整型指针。同样地,您也可以传递一个多维数组作为形式参数。
方式 1
形式参数是一个指针(您可以在下一章中学习到有关指针的知识):
1 | |
方式 2
形式参数是一个已定义大小的数组:
1 | |
方式 3
形式参数是一个未定义大小的数组:
1 | |
函数
函数是一组一起执行一个任务的语句。每个 C 程序都至少有一个函数,即主函数 main() ,所有简单的程序都可以定义其他额外的函数。
函数声明告诉编译器函数的名称、返回类型和参数。函数定义提供了函数的实际主体。
C 标准库提供了大量的程序可以调用的内置函数。例如,函数 strcat() 用来连接两个字符串,函数 memcpy() 用来复制内存到另一个位置。
此部分原链接
定义函数
C 语言中的函数定义的一般形式如下:
1 | |
在 C 语言中,函数由一个函数头和一个函数主体组成。下面列出一个函数的所有组成部分:
- 返回类型:一个函数可以返回一个值。return_type 是函数返回的值的数据类型。有些函数执行所需的操作而不返回值,在这种情况下,return_type 是关键字 void。
- 函数名称:这是函数的实际名称。函数名和参数列表一起构成了函数签名。
- 参数:参数就像是占位符。当函数被调用时,您向参数传递一个值,这个值被称为实际参数。参数列表包括函数参数的类型、顺序、数量。参数是可选的,也就是说,函数可能不包含参数。
函数主体:函数主体包含一组定义函数执行任务的语句。
函数参数
如果函数要使用参数,则必须声明接受参数值的变量。这些变量称为函数的形式参数。
形式参数就像函数内的其他局部变量,在进入函数时被创建,退出函数时被销毁。
当调用函数时,有两种向函数传递参数的方式:
| 调用类型 | 描述 |
|---|---|
| 传值调用 | 该方法把参数的实际值复制给函数的形式参数。在这种情况下,修改函数内的形式参数不会影响实际参数。 |
| 引用调用 | 通过指针传递方式,形参为指向实参地址的指针,当对形参的指向操作时,就相当于对实参本身进行的操作。 |
默认情况下,C 使用传值调用来传递参数。一般来说,这意味着函数内的代码不能改变用于调用函数的实际参数。
指针
此部分原链接
每一个变量都有一个内存位置,每一个内存位置都定义了可使用 & 运算符访问的地址,它表示了在内存中的一个地址。
指针也就是内存地址,指针变量是用来存放内存地址的变量。就像其他变量或常量一样,您必须在使用指针存储其他变量地址之前,对其进行声明。指针变量声明的一般形式为:
1 | |
在这里,type 是指针的基类型,它必须是一个有效的 C 数据类型,var_name 是指针变量的名称。用来声明指针的星号 * 与乘法中使用的星号是相同的。 但是,在这个语句中,星号是用来指定一个变量是指针。以下是有效的指针声明:
1 | |
所有实际数据类型,不管是整型、浮点型、字符型,还是其他的数据类型,对应指针的值的类型都是一样的,都是一个代表内存地址的长的十六进制数。
不同数据类型的指针之间唯一的不同是,指针所指向的变量或常量的数据类型不同。
指针使用实例
1 | |
当上面的代码被编译和执行时,它会产生下列结果:
1 | |
指针的运算
C 指针是一个用数值表示的地址。因此,您可以对指针执行算术运算。可以对指针进行四种算术运算:++、–、+、-。
假设 ptr 是一个指向地址 1000 的整型指针,是一个 32 位的整数,让我们对该指针执行下列的算术运算:ptr++
在执行完上述的运算之后,ptr 将指向位置 1004,因为 ptr 每增加一次,它都将指向下一个整数位置,即当前位置往后移 4 字节。这个运算会在不影响内存位置中实际值的情况下,移动指针到下一个内存位置。如果 ptr 指向一个地址为 1000 的字符,上面的运算会导致指针指向位置 1001,因为下一个字符位置是在 1001。
我们概括一下:
指针的每一次递增,它其实会指向下一个元素的存储单元。
指针的每一次递减,它都会指向前一个元素的存储单元。
指针在递增和递减时跳跃的字节数取决于指针所指向变量数据类型长度,比如 int 就是 4 个字节。
指针的比较
指针可以用关系运算符进行比较,如 ==、< 和 >。如果 p1 和 p2 指向两个相关的变量,比如同一个数组中的不同元素,则可对 p1 和 p2 进行大小比较。
结构体
此部分原链接
C 数组允许定义可存储相同类型数据项的变量,结构是 C 编程中另一种用户自定义的可用的数据类型,它允许您存储不同类型的数据项。
定义结构
为了定义结构,须使用 struct 语句。struct 语句定义了一个包含多个成员的新的数据类型,struct 语句的格式如下:
1 | |
- tag 是结构体标签。
- member-list 是标准的变量定义,比如 int i; 或者 float f,或者其他有效的变量定义。
- variable-list 结构变量,定义在结构的末尾,最后一个分号之前,您可以指定一个或多个结构变量。
共用体
共用体是一种特殊的数据类型,允许您在相同的内存位置存储不同的数据类型。您可以定义一个带有多成员的共用体,但是任何时候只能有一个成员带有值。 共用体提供了一种使用相同的内存位置的有效方式。
定义共用体
为了定义共用体,您必须使用 union 语句,方式与定义结构类似。union 语句定义了一个新的数据类型,带有多个成员。union 语句的格式如下:
1 | |
union tag 是可选的,每个 member definition 是标准的变量定义,比如 int i; 或者 float f; 或者其他有效的变量定义。在共用体定义的末尾,最后一个分号之前,您可以指定一个或多个共用体变量,这是可选的。下面定义一个名为 Data 的共用体类型,有三个成员 i、f 和 str:
1 | |
现在,Data 类型的变量可以存储一个整数、一个浮点数,或者一个字符串。这意味着一个变量(相同的内存位置)可以存储多个多种类型的数据。您可以根据需要在一个共用体内使用任何内置的或者用户自定义的数据类型。
共用体占用的内存应足够存储共用体中最大的成员。例如,在上面的实例中,Data 将占用 20 个字节的内存空间,因为在各个成员中,字符串所占用的空间是最大的。
为了访问共用体的成员,我们使用成员访问运算符(.)
1 | |
当上面的代码被编译和执行时,它会产生下列结果:
1 | |
计算机网络
计算机网络体系结构
此部分原链接
计算机网络的体系结构是指这个计算机网络及其部件所应完成 的功能的一组抽象定义,是描述计算机网络通信方法的抽象模型结构,一般是指计算机网络的各层及其协议的集合。
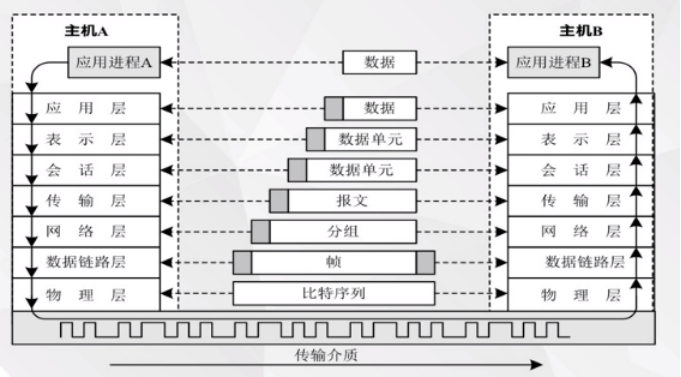
OSI参考模型
分层原则
- 网中各结点都具有相同的层次
- 不同结点的同等层具有相同的功能
- 同一结点内相邻层之间通过接口通信
- 每层可以使用下层提供的服务,并向其上层提供服务
- 不同结点的对等层通过协议来实现对等层次之间的通信
层次结构
1.物理层:利用传输介质实现比特序列的传输(比特序列也就是二进制位),它需要为它的上层数据链路层提供服务。
2.数据链路层:采用差错控制与流量控制方法,使得有差错的物理线路变成无差错的数据链路
3.网络层(network layer):实现路由选择、分组转发与拥塞控制等功能,为“分组”传输选择“最佳”的路由
4.运输层(transport layer):向高层用户提供可靠的“端-端”通信服务,向高层屏蔽下层数据通信的具体细节
5.会话层(session layer):维护两个通信计算机之间的进程通信,管理数据交换
6.表示层(presentation layer):处理两个通信的计算机系统的数据表示方式,完成数据的格式变换、加密与解密、压缩与恢复
7.应用层(application layer):需要为用户提供一个平台,允许用户去开发能够满足自己需求的网络通讯。为应用软件提供多种网络服务,例如万维网、文件传输、电子邮件与其它服务等
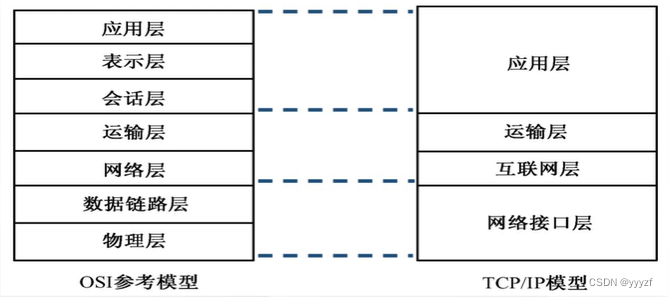
TCP/IP参考模型
层次结构
网络接口层
是 TCP/IP 参考模型的最低层,它负责通过网络发送和接收IP数据。互联网层:
使用IP协议提供“尽力而为(best effort)”的网络分组传输服务。将运输层报文段封装成IP数据报,选择适当的发送路径并将数据报转发到下一个结点。(关键部分)运输层:
负责在会话的进程之间建立和维护“端-端”的连接。定义了两种不同的协议:传输控制协议(TCP)与用户数据报协议(UDP)。(UDP特点是高效,对可靠性要求不高,但是对实时性要求比较高的传输。我们可以使用它为其服务,比如说传输语音,传输视频)应用层:
和 OSI 参考模型的应用层类似,为应用软件提供多种网络服务
物理层
此部分原链接
基本概念
数据、信号与码元
数据是传送信息的实体。信号则是数据的电气或电气表现,是数据在传输过程中的存在形式。
连续变化的数据或信号称为模拟数据或模拟信号;取值仅允许为有限的几个离散数据的数据或信号称为数字数据或数字信号。
数据的传输方式可分为串行传输和并行传输。串行传输是指1比特1地按照时间顺序传输(远距离通信通常采用串行传输),并行传输是指若干比特通过多条通信信道同时传输。
码元是指用一个固定时长的信号波形(数字脉冲)表示一位k进制数字,代表不同离散数值的基本波形,是数字通信中数字信号的计量单位。时长内的信号称为k进制码元,该时长称为码元宽度。
信源、信道与信宿
数据通信是指数字计算机或其他数字终端之间的通信,一个数据通信系统主要划分为信源、信道和信宿三部分。
信源是产生和发送数据的源头;
信宿是接受数据的终点。
发送端信源发出的信息需要通过变换器转换成适合于在信道上传输的信号,而通过信道传输到接收端的信号先有反变换器转换成原始信息,再发送给信宿。
信道与电路并不等同,信道是信号的传输媒介。一条通信线路往往包含一条发送信道和一条接收信道。噪声源是信道上的噪声(对信号的干扰)及分散在通信系统其他各处的噪声的集中表示。
信道按传输信号形式的不同,可分为传送模拟信号的模拟信道和传送数字信号的数字信号两大类。
信道按传输介质的不同可分为无线信道和有限信道。
信道上传输的信号有基带信号和宽带信号之分。基带信号将数字信号1,0直接用两种不同的电压表示,传送到数字信道上传输(基带传输);宽带信号将基带信号进行调制后形成频分复用模拟信号,送到模拟信道上传输(宽带传输)。
从通信双方信息的交互方式看,可分为三种基本方式:
- 单向通信。只有一个方向的通信而没有反方向的交互,仅需一条信道。如无线电广播、电视广播。
- 半双工通信。通信的双方都可以发送和接受信息,但任何一方都不同同时发送和接受信息,因此需要两条信道。
- 全双工通信。通信双方都可以同时发送和接受信息,需要两条信道。
信道的极限容量是指信道的最高码元传输速率或信道的极限信息传输速率。
速率、波特与带宽
速率也称数据率,值数据传输速率,表示单位时间内传输的数据量。可用码元传输速率和信息传输速率表示。
- 码元传输速率。又称波特率,表示单位时间内数字通信系统所传输的码元个数(也称脉冲个数或信号变化的次数);单位波特(Baud)1波特表示数字通信系统传输一个码元;码元速率与进制数无关,可以是多进制的也可以是二进制的。
- 信息传输速率。又称信息速率、比特率等,表示单位时间内数字通信系统传输的二进制码元格式(比特数),单位是比特/秒(b/s)
注:波特和比特是两个不同的概念,码元传输速率也称调制速率、波形速率或符号速率。但码元传输速率与信息传输速率在数量却有一定关系。如一个码元携带n比特的信息量,则M波特率的码元传输速率所对应的信息传输速率为Mn比特/秒。
带宽原指信号具有的频带宽度,单位赫兹(Hz)。带宽与数据率存在数值上的互换关系,因此常用来表示网络的通信线路所能传输数据的能力。因此,带宽表示单位时间内从网络的某一点到另一点所能通过的最高数据率。此时带宽的单位不是Hz,而是b/s。
编码与调制
数据无论是数字的还是模拟的,为了传输都必须转变为信号。把数据变换为模拟信号的过程称为调制,把数据变换为数字信号的过程称为编码。
信号是数据的具体表现形式。数字数据可以通过数字发送器转换为数字信号传输,也可通过调制转换成模拟信号传输;同样的,模拟数据可以通过PCM编码器转换成数字信号传输,也可以通过放大器调制器转换成模拟信号传输。这样新城了下列4中编码方式。
- 数字数据编码为数字信号
数字数据编码用于基带传输中,在基本不改变数字信号数据频率情况下,直接传输数字信号。- 归零编码(RZ)。在RZ中用高电平电表1、低电平代表0(或者相反)。每个时钟周期的中间均跳变到低电平(归零),接收方根据跳变调整本方的时钟基准,这为传输双方提供了自同步机制。但归零需要占用一定带宽,因此传输效率收到了一定的影响。
- 非归零编码(NRZ)。NRZ与RZ区别是不用归零。一个周期可全部用来传输数据。但NRZ编码无法传递时钟信号,双方难以同步,若需传输告诉同步数据,需要都带有时钟线。
- 反向非归零编码(NRZI)。NRZI与NRZ的区别是用信号的翻转代表0,信号保持不变代表1,翻转的信号本身可以作为一种通知机制。这种编码方式继承了前两种编码的优点,技能传输时钟信号,又能尽量不损失系统带宽。例如USB2.0的通信编码方式就是NRZI编码。
- 曼切斯特编码。ME将一个码元分成两个相等的间隔。前一个为高电平而后一个为低电平表示码元1;码元0的表示方法正好相反。该编码特点是,在每个码元的中间出现电平跳变,位中间的跳变即作为时钟信号(可用于同步),有作为数据信号,但所占的频带宽度是原始频带宽度的两倍。例如以太网使用的编码方式就是曼切斯特编码。
- 差分曼切斯特编码。常用于局域网传输。其规则为:若码元为1,则前半个码元的电平与上一码元的后半个码元的电平相同;若码元为0,则情形相反。该编码特点是,在每个码元中间都有一次电平的的跳转,可实现自同步,且抗干扰性较好。
- 4B/5B编码,将欲发数据流的每4位作为一组,按照4B/5B编码规则将其转换成相应的5位码。5位码共32种组合。但只采用其中的16种对应16种不同的4位码,其他16种作为控制码或保留。
- 数字数据调制为模拟信号
数字数据调制技术在发送端将数字信号转换为模拟信号,而在接收端将模拟信号换源为数字信号,分别对应调制解调器的调制和解调过程。基本的数字调制方法有如下几种:幅移键控(ASK)。通过改变载波信号的振幅来表示数字信号1,和0,而载波的频率和相位都不改变。笔记容易实现,但抗干扰能力差。
频移键控(FSK)。通过改变载波信号的频率来表示数字喜好1和0,而载波的振幅和相位都不改变,容易实现,抗干扰能力强,应用广泛。
相移键控(PSK)。通过改变载波信号的相位来表示数字信号1和0,而载波的振幅和频率都不改变。它又分为绝对调相和相对调相。
正交振幅调制(OAM)。在频率相同的前提下,将ASK和PSK结合起来,形成叠加信号。
- 模拟数据编码为数字信号
这种编码方式最典型的例子是常用于对音频信号进行编码的脉码调制(PCM)。主要包括三个步骤,采样、量化和编码。
采样定理:将模拟信号转换成数字信号时,结社原始信号中的最大频率为f,那么采样频率f(采样)必须大于等于最大频率f的两倍,才能保证采样后的数字信号完整保留原始模拟信号的信息。采样定理又称为奈奎斯特定理。
采样是指对模拟信号进行周期性扫描,把时间上连续的信号变成时间上离散的信号。根据采样定理,当采样的频率大于等于模拟数据的频带宽度(最高变化频率)的两倍时,所得的离散信号可以无失真地代表被采样的模拟数据。
量化是把采样取得的点评幅值按照一定的分级标度转化为相应的数字值并取整数,这样就把连续的电平幅值转换为了离散的数字量。采样和量化的实质就是分割和转换。
编码是把量化的结果转化为与之相对应的二进制编码。 - 模拟数据调制为模拟信号
为实现传输的有效性,可能需要较高的频率。这种调制方式可以使用频分复用(FDM)技术。充分利用带宽资源。例如电话机和本地局交换机采用模拟信号传输模拟数据的编码方式,模拟的声音数据时加载到模拟的载波信号中传输的。